高通量虚拟筛选技术在药物研发中的应用
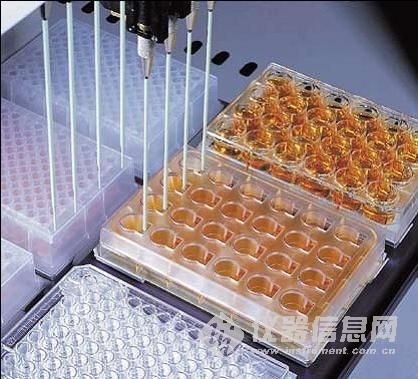
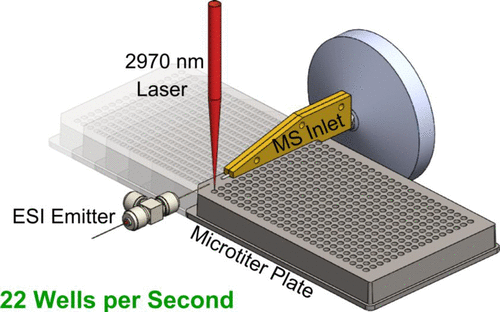
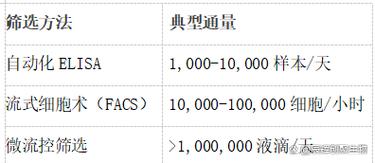
药物研发是一项周期长、成本高、风险大的系统工程。传统的高通量筛选(High-Throughput Screening, HTS)通过自动化实验对海量化合物进行生物活性测试,极大提升了发现先导化合物的效率,但其仍依赖实体化合物库,存在成本高昂、假阳性率高、可筛选化学空间有限等瓶颈。高通量虚拟筛选(High-Throughput Virtual Screening, HTVS)技术应运而生,它借助计算机辅助药物设计(CADD)方法,从海量虚拟化合物库中快速识别潜在活性分子,显著降低了实验筛选的盲目性和成本,已成为现代药物发现的重要工具。本文将系统介绍高通量虚拟筛选的技术原理、常用方法、应用流程及其在药物研发中的典型应用与未来前景。
一、高通量虚拟筛选的技术原理与核心方法
高通量虚拟筛选的核心在于利用分子建模和计算化学算法,对大规模化合物数据库进行自动化的结合亲和力预测或药理学性质评估。根据是否考虑受体蛋白的三维结构,可将其分为两大类:基于受体结构的虚拟筛选(SBVS)和基于配体结构的虚拟筛选(LBVS)。
1. 基于受体结构的虚拟筛选(SBVS)
该方法又称分子对接(Molecular Docking),前提是已知靶标蛋白的三维结构(通过X射线晶体学、冷冻电镜或同源建模获得)。其基本流程包括:
- 靶标准备:去除水分子、添加氢原子、分配电荷、确定结合位点。
- 化合物库准备:生成化合物的三维构象、质子化状态和互变异构体。
- 对接计算:将每个化合物对接到靶标结合口袋中,通过搜索算法(如遗传算法、蒙特卡洛模拟)优化构象,并采用打分函数(如基于力场、经验或知识的打分函数)评估结合自由能。
- 后处理:对打分结果进行重打分、聚类分析和目视检查,挑选候选化合物。
为了提升通量,常采用分层策略:先用快速粗筛(如高阈值打分)剔除大部分化合物,再用精细对接或分子动力学模拟对少量化合物进行精确评估。
2. 基于配体结构的虚拟筛选(LBVS)
当靶标结构未知或不可用时,可采用LBVS。该方法基于“相似分子具有相似活性”的原理,通过药效团模型、分子相似性(如指纹、形状叠合)或机器学习(如QSAR、深度学习)从化合物库中寻找与已知活性配体相似的分子。常用的工具有:
- 药效团筛选:构建反映活性必需特征的药效团模型(氢键供体/受体、疏水中心、芳香环等),筛选匹配的化合物。
- 分子相似性搜索:利用ECFP、MACCS等指纹计算Tanimoto系数,或采用基于形状的叠合方法(如ROCS)。
- 机器学习模型:使用已知活性/非活性数据训练分类或回归模型,预测新化合物的活性。
3. 混合方法与人工智能增强
整合SBVS与LBVS的混合方法(如共识打分)提高了命中率。人工智能特别是深度学习技术(如卷积神经网络、图神经网络、生成模型)被用于虚拟筛选,能够更准确地预测结合亲和力、ADMET性质,甚至直接生成具有理想活性的新分子。
二、高通量虚拟筛选的实施流程与关键技术
一个完整的高通量虚拟筛选项目通常包含以下阶段:
- 靶标选择与验证:确定与疾病相关的关键生物大分子(如酶、受体、离子通道),并验证其可成药性。
- 化合物库构建:来源包括商业库(如ZINC、Enamine)、公共库(如PubChem、ChEMBL)以及自定义库。需进行预处理:去重、去除非药物类结构、生成多质子化状态和立体异构体。库规模从数百万到数十亿不等(如Ultra-Large Library)。
- 筛选算法与参数优化:根据靶标特点选择合适的对接软件(如AutoDock Vina、Schrödinger Glide、MOE、LeDock)及打分函数,并对关键参数(如盒子大小、穷尽性)进行验证。
- 大规模计算与结果分析:利用高性能计算集群或云计算资源并行处理。对初筛结果进行重打分、一致性打分、结合模式分析,并考虑化合物的多样性、类药性(Lipinski规则、Veber规则)和ADMET预测。
- 实验验证:购买或合成排名靠前的候选化合物,进行体外酶活或细胞活性测试,进而开展构效关系研究和先导化合物优化。
三、高通量虚拟筛选在药物研发中的应用场景
HTVS已广泛应用于多个治疗领域,显著加速了先导化合物的发现进程。
- 抗肿瘤药物:针对激酶(如EGFR、VEGFR、CDK)、表观遗传靶点(如BRD4、EZH2)和蛋白-蛋白相互作用(如MDM2-p53、PD-1/PD-L1),通过HTVS发现了大量新型抑制剂,部分已进入临床研究。
- 抗病毒药物:在新冠疫情中,HTVS被用于筛选SARS-CoV-2主蛋白酶(Mpro)、RNA依赖的RNA聚合酶(RdRp)和刺突蛋白的抑制剂,从现有药物库中快速识别出瑞德西韦、氯喹等潜在药物(后续验证部分有效)。
- 抗感染与抗菌:针对细菌耐药靶点(如β-内酰胺酶、DNA旋转酶)和结核分枝杆菌,HTVS帮助发现了新结构类型的抗菌先导物。
- 神经系统疾病:针对阿尔茨海默病的β-分泌酶(BACE1)、tau蛋白聚集,以及帕金森病的α-突触核蛋白,虚拟筛选提供了多类神经保护剂候选。
- 罕见病与孤儿药:对于缺乏大量化合物库的罕见病靶点,HTVS可通过基于结构的药物设计快速找到活性分子,降低研发门槛。
四、挑战与未来发展方向
尽管HTVS成效显著,但仍面临多重挑战:
- 打分函数精度有限:无法准确描述溶剂效应、熵变和构象变化,导致假阳性/假阴性。
- 化合物库质量与规模:超大库的计算成本高,且库中许多分子难以合成或缺乏类药性。
- 靶标柔性:蛋白质构象变化(诱导契合)难以在刚性对接中体现。
为应对这些挑战,未来发展方向包括:
- 增强采样与自由能计算:如MM/PBSA、自由能微扰(FEP)与对接结合,提高预测可靠性。
- 人工智能与大数据:利用深度学习进行打分、分子生成、合成可行性预测,并整合多组学数据。
- 云平台与超大库筛选:基于云计算的超大规模虚拟筛选(如虚拟筛选十亿级化合物库)正成为新趋势。
- 与实验技术融合:如DNA编码化合物库(DEL)与虚拟筛选互补,冷冻电镜与计算结合等。
高通量虚拟筛选技术弥合了传统高通量实验筛选与合理药物设计之间的鸿沟,通过计算手段高效探索巨大化学空间,大幅降低了药物发现的成本和时间。随着算法、算力和数据资源的持续进步,HTVS将在新靶点发现、老药新用和个性化药物开发中发挥更加关键的作用,推动药物研发进入智能化、精准化的新阶段。
如若转载,请注明出处:http://www.liuyuancorp.com/product/40.html
更新时间:2026-10-05 21:25:13